
搜索到
82
篇与
的结果
-
![奇葩代码注释]()
-
![gitbook入门]() gitbook入门 gitbook 生成电子书主要有三种方式:gitbook-cli 命令行操作,简洁高效,适合从事软件开发的相关人员.gitbook-editor 编辑器操作,可视化编辑,适合无编程经验的文学创作者.gitbook.com 官网操作,在线编辑实时发布,适合无本地环境且科学上网的体验者.本文主要讲解第一种 gitbook-cli 命令行操作流程gitbook 的一些常用命令安装 gitbook-cli 脚手架工具本机已安装 node.js 开发环境,安装完成后运行 gitbook -V 能够打印出版本信息,则表示安装成功.1.创建文件夹用于存放电子书(md)文件2.输入cmd进入命令行3.安装gitbook客户端npm install -g gitbook-cli 4.初始化 gitbook 项目gitbook init 初始化项目,按照 gitbook 规范会自动创建 README.md 和 SUMMARY.md 两个文件SUMMARY.md 是电子书的章节目录,gitbook 会初始化相应的文件目录结构,所以主要是用于开发初始阶段.打开polyfills.js文件,找到这个函数看注释应该用来处理旧版本的问题,查看这个方法的调用位置发现在61-63行再次执行 gitbook init # Summary * [Introduction](INTRODUCTION.md) * [Chapter 1](CHAPTER1.md) * [Section 1.1](CHAPTER1_SECTION1.md) * [Section 1.2](CHAPTER1_SECTION2.md) * [Chapter 2](CHAPTER2.md) * [Section 2.1](CHAPTER2_SECTION1.md) * [Section 2.2](CHAPTER2_SECTION2.md) * [Conclusion](CONCLUSION.md) 5.启动 gitbook 项目gitbook serve启动本地服务,程序无报错则可以在浏览器预览电子书效果: http://localhost:4000由于能够实时预览电子书效果,并且大多数开发环境搭建在本地而不是远程服务器中,所以主要用于开发调试阶段.重启启动本地服务,查看修改后的内容,手动创建对应md文件6.构建 gitbook 静态网页构建静态网页而不启动本地服务器,默认生成文件存放在 _book/ 目录,当然输出目录是可配置的,暂不涉及输出静态网页后可打包上传到服务器,也可以上传到 github 等网站进行托管,因而主要用于发布准备阶段.gitbook build章节小结gitbook init 初始化 README.md 和 SUMMARY.md 两个文件.gitbook build 本地构建但不运行服务,默认输出到 _book/ 目录.gitbook serve 本地构建并运行服务,默认访问 http://localhost:4000 实时预览.
-
![品味经典废话文学]() 品味经典废话文学 年轻人你记住,你别管记住什么,你就记住情况就是这么个情况,具体什么情况还得看情况听了你的分析,我决定再分析分析给你提个建议,不要随便给别人提建议睡觉的时候一定要闭上眼,不然睡不着但凡你说的话沾点边,也不至于一点边不沾看似很危险,其实一点也不安全如果我没猜错的话,那我一定是猜对了。有件事说出来你可能不信,那我就不说了这件事说来话长,那我就长话短说了但凡你有点本事,也不至于一点本事都没有三人行,必有三人台上 1 分钟,台下 60 秒。听君一席话,如听一席话。我上次这么无语还是在上次。你要是不丑的话,应该还挺好看的每呼吸六十秒,生命就会减少一分钟。这个西红柿,有一股番茄味。运气这东西,全靠运气。现在的局面就是这个局面,至于到底是什么局面,得看后续局面的发展这个东西看起来很难,实则一点都不简单你这文章除了开头中间结尾不太好,整体看上去还是不错的姜还是老的老我想长话短说呀,但是说来话长啊回想起昨天,仿佛就在昨天一想到要睡觉了,就兴奋的睡不着经过严密的调查,我发现我调查的不够严密老师对我们说这些东西不用背,记住就行了小伙子你真不错,年纪轻轻就这么年轻了
-
![格局]() 格局 稻盛和夫说:“你一天收入100元,有人骂你,你会很生气;你一天收入1000元,有人骂你,你会不屑;你一天收入10000元,有人骂你,你会毫不在意,甚至同情骂你的人。一个人之所以痛苦,是因为高度不够,看到的都是问题。格局太小,纠结的都是鸡毛蒜皮,放大你的格局,你的人生将不可思议。”人活一辈子,都想有个好结局,但是这个好结局,往往都是我们的格局决定的。一个人如果格局太小,其结局往往都不会太好,但如果他格局很大,那他的结局往往不会差。格局就如同你攀一座高山,当你在山下看到的都是密密麻麻的人,心里总会莫名的烦躁。当你爬到山顶去看看,去感受不一样的视角后,心中所想就完全不一样了。如果你站在1楼,有人骂你,你听了非常生气。如果你站在10楼,有人骂你,你还以为他给你打招呼,因为听不清。如果你站在100楼,有人骂你,你根本听不见,也看不见。格局小的人,往往容易陷入生活的琐碎之中,总喜欢计较,总喜欢抱怨,总喜欢生气,还这看不惯,那也看不惯,这样的人,注定人生过得很痛苦。总有一天,你会明白,真正能够治愈你的,从来都不是时间,而是你心里那段释怀和格局,只要你内心不慌乱,就连世界都影响不到你。欲成大树,莫与草争,将军有剑,不斩苍蝇。不要与不重要的人,计较重要的事情;不要与重要的人,计较不重要的事情。我们与人相处,与人为善,与己为善,与人有路,与己更宽。对人,多一点包容,多一点大气;做事,不要太计较眼前,眼光要长远。改变不了别人,就先改变自己,生活不宠你,你就更要善待自己。真正厉害的人,不是没有情绪,而是内心足够强大,不会被情绪左右。当你到达了一定高度,有了钱,有了本事,有了实力,你的格局自然就大了,就不会再去纠结生活中的鸡毛蒜皮,也不会为那些琐碎的小事而烦恼。一个人真正的格局,不在于他多厉害,算计了多少人,而是在于他做出了多少贡献,帮助了多少人。格局大的都是相互成就,格局小的才会相互伤害。格局都是被委屈撑大的,心中有事,还能若无其事便是格局;心中有事,装着若无其事便是阅历。不要被外界干扰你的情绪,放大你的格局,你的人生将不可思议。位置不同,少言为贵;认知不等,不争不辩;三观不合,浪费口舌。提升自己的认知和境界,眼到之处皆是风景,心到之处皆是清欢,格局越大,人生才会越美好。
-
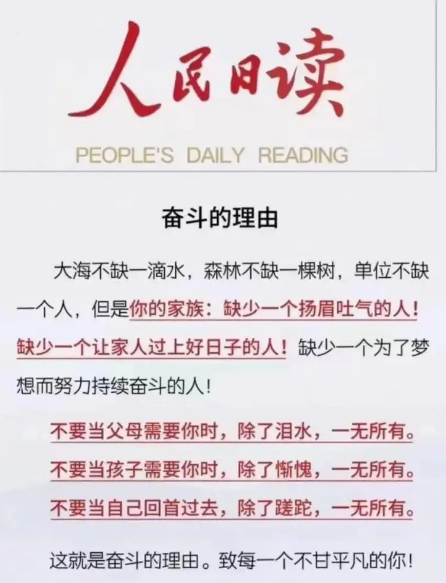
![大海不缺一点水,森林不缺一棵树,单位不缺一个人,但是你的家族缺少一个扬眉吐气的人!]() 大海不缺一点水,森林不缺一棵树,单位不缺一个人,但是你的家族缺少一个扬眉吐气的人! “大海不缺一点水,森林不缺一棵树,单位不缺一个人,但是你的家族缺少一个扬眉吐气的人!缺少一个让家人过上好日子的人!缺少一个为了梦想而努力持续奋斗的人!不要当父母需要你时,除了泪水,一无所有。不要当孩子需要你时,除了惭愧,一无所有。不要当自己回首过往,除了蹉跎,一无所有,这就是奋斗的理由。致每一个不甘平凡的你!加油!没有靠山,自己就是山!没有天下,自己打天下!没有资本,自己赚资本!活着就该逢山开路,遇水架桥!生活你给我压力,我还你奇迹!”草木一春,人生一世,对于浩瀚无垠的宇宙来说,我们的生命十分的渺小,犹如沙尘,蝼蚁,十分的微不足道。但是对于我们自己来说,却是一个鲜活的生命存在,你可以感受到痛苦,感受喜悦,感受到活着所有经历的一切。你也可以用有限的一生,去实现自己的理想,做自己想做的事情,吃自己想吃的东西,见自己想见的人,爱自己想爱的人,去你想去的地方。大海从来不会少一滴水而枯竭,森林从来不会因为少一棵树而灭亡,宇宙更不会少一个生命不存在,单位也不会少一个你不运转。也许对于外界来说,我们就是可有可无的人,但是对于你的家人来说,却是整个家庭的顶梁柱,也是整个家庭的希望,家庭不能少你一个人。对于家庭来说,你就是半边天,是年迈父母最大的寄托,他们盼望着儿女有出息,将来可以成为他们的依靠。你也是爱人的天地,孩子的靠山,世界少了一个你,地球照样运转,太阳依旧东升西落,但是家庭少了你,整个天都要塌下来了。王志文说: “人啊,到了一定的年龄后,没有了稳定经济来源,没有了存款,一旦家庭开支孩子的教育,你拿不出钱来维持,那么你就会明白,什么脸不脸的,什么情啊爱啊,就都是浮云。”人到一定年纪,你终将会明白,嘴巴说得天花乱坠,都不如拿出金钱实在。爱情再浪漫美好,没有物质基础维系的情感都会支离破碎。当你碰到年迈的父母需要你的时候,别除了眼泪就是一无所有了,别等到爱人需要你的时候,除了只会说还有我,什么都不能解决了。人生之所以需要去奋斗,那是因为我们背后有无数爱我们的人,不想让爱你的人失望透顶,不想让自己一事无成,必须要去拼搏努力。奋斗也是给予自己一次挑战的机会,生命来到此生,我们就应该为了这个世界而奋斗,为我们所爱的人奋斗,也为了成为更好的自己奋斗。没有靠山,那就成为自己的靠山,没有关系,那就不断的找关系,没有能力,不断的锻炼自己的能力,总有一天,你也会登上巅峰,带着所爱的人一起欣赏山顶的美景。因此,幸福的人生都是靠奋斗出来,所有的压力都变成动力,在前行之中找到自信,创造更多的财富。同时也可以实现自己的价值,为家人扬帆领航,遮风挡雨,成为他们永远的避风港!
-
![撒贝宁的这段话杀死了我的堕落]() 撒贝宁的这段话杀死了我的堕落 撒贝宁说:“如果你一天到晚拿着手机,刷着微博,坐在家里,宅着看电视,天天上着网,做着那些80岁以后都能干的事,你要青春干什么呢?如果命运是世界上最烂的编剧,你就一定要努力争取,做你自己人生最好的演员。”打游戏、刷短视频当然很爽,但爽完后是极度的空虚;早起跑步、啃专业书当然很累,但累完后是满满的幸福。放纵无限,青春有限,生命只有一次,青春无法回头。如果你在该奋斗的年纪就选择躺平,等年纪大了,在该躺平的年纪就会发现根本没有躺平的资本。低级的欲望,放纵即可获得;而高级的欲望,只有克制才能达成。努力,不是为了给任何人看,也不是为了感动自己,而是为了让自己有能力拥有更多的可能性。这个社会会淘汰没有价值的人,要认真地去经营自己,只有成为一个自身有价值的人,才会被这个世界温柔以待。这个世界没有避风港,更没有救世主,只有你自己,才是自己最后的庇护所。人生有时很难,但不努力更难。今天的努力就是为了将来的不难,让自己有底气,抵御生活风雨,不惧人生苍凉。人生在世,放纵是本能,自律是修行,自强才是本事。不要成为低级快乐的傀儡,要做自己人生的主人,遇见更好的自己。
-
![人生箴言]() 人生箴言 “如果拜佛有用,你连庙门都挤不进去;如果种地能挣大钱,农民将无地可种;如果献血有利健康,排一辈子队你也别想献血;如果人生如意,那么一出生时我们也不会哭。”如果天上有馅饼掉下来,那么大街早已排满了人。如果守株待兔有用,那么每一个人都不会努力。人生这一碗饭,每一个人都希望幸运之神降临到自己,靠天靠地靠爹靠娘靠朋友,真正可靠的还是自己。自己是一个懒惰虫,就算天上有馅饼,也需要你早起,就算佛祖显灵,也需要你有一定的能力具备。拜佛拜的心中的欲望,如果花几块钱,许下几千万的愿望,能够梦想成真,那么庙门早已是人山人海了。人生当中,很多事情都需要自己去努力,去奋斗,幸福的生活从来不是好吃懒做、游手好闲得到,一定是前提建立自身强大的基础上。古语有言:小财靠勤,中财靠德,大财靠命。勤能补拙,笨鸟先飞,只要你肯勤快,每一个人都能解决自己最基本的生存问题,至少不用风餐露宿,衣不蔽体。但凡那些有一定财富的人,都需要自身的智慧和能力,有一定的德行,才能够赚到属于自己的财富。大财那就是需要天时地利人和,三者结合在一起,那需要机缘巧合,一切刚刚好。一生当中,求人不如求己,靠山山会倒,靠树树会倒,靠人人会跑,别人给的是恩赐,自己打的才是江山。陆游诗人写道:“君记取,封侯事在。功名不信由天。”你也要记住啊,建功封侯的大事,都是需要自己去争取的,不是等待上天来安排的。人活着,你想要生命里的荣华富贵,权势地位,飞黄腾达,金银财宝,珍珠玛瑙无数,这些都需要自己去争取,自己去奋斗,天上从来不会掉馅饼。就如路遥在《平凡的世界》有说:“幸福的人生都是奋斗出来的。”作为我们一个人,不要抱怨自己的出生,谁也无法改变出生,不如既来之,则安之。想要什么样的生活,就朝着自己的梦想去奋斗,人就是这样,你不逼自己一把,永远不知道自己到底有多厉害。因此,人生这一条路,充满了无数的坎坷和波折,既然无处可逃,与其异想天开,不如坦然面对现实,好的生活一定是奋斗出来,从来没有一劳永逸的事情!
-
![好用的软件分享]() 好用的软件分享 1.全球最好用的浏览器:谷歌浏览器 chrome 市场份额排名第一https://www.google.cn/chrome/index.html2.简单切强大的输入法:搜狗智慧版https://pinyin.sogou.com/zhihui/3.个人杀毒软件:火绒安全软件https://www.huorong.cn/4.电脑最好清理软件,无需安装杀毒软件:ccleaner + 计算机磁盘清理https://www.ccleaner.com/zh-cn/ccleaner5.免费且强大的压缩解压软件:7zip 软件体积小 压缩率更高 支持多种格式https://www.7-zip.org/6.支持所有视频格式,倍速播放,小巧切强大:potplayerhttp://www.potplayercn.com/download7.功能强大录屏软件:ev录屏https://www.ieway.cn/8.小巧切强大的截图软件:Snipaste截图 办公,教学都在使用https://www.snipaste.com/download.html9.比QQ好用的远程控制软件: 向日葵https://sunlogin.oray.com/10.pc端电脑闹钟:梦畅闹钟http://www.naozhong.net/11.磁盘分区,数据恢复等:diskgeniushttps://www.diskgenius.cn/12.正版操作系统,正版软件:iTellYouhttps://next.itellyou.cn/13.屏幕放大软件:zoomit 适合教学https://learn.microsoft.com/zh-cn/sysinternals/downloads/zoomit14.阿里云盘:第三方客户端: 蜗牛云盘 不限速下载,上传https://snail8.cn/html/index.html15.个人导航站:旭辉网址导航https://www.itnan.cc16.音乐播放神器~千千静听链接: https://pan.baidu.com/s/1nnGu0pnvHUUxIQN0Bn6WkA?pwd=yhh7 17.PDF文档编辑神器 PDF-XChange链接: https://pan.baidu.com/s/12wLiadkX0Y7pjPVguKNTQg?pwd=rjhr 18.加密隐藏电脑小秘密神器 ulockhttps://pan.baidu.com/s/1ZVxjVNQXeIaXuEq7BgbeWA?pwd=6rbu 19.飞书注册使用https://accounts.feishu.cn/accounts/page/login?app_id=100&no_trap=1&redirect_uri=https%3A%2F%2Faccounts.feishu.cn%2Faccounts%2Fsecurity%2Fpage%2F
-
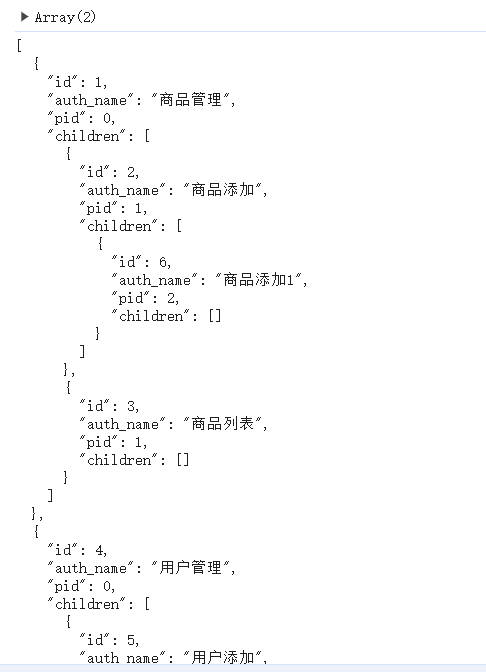
![JS实现无限级分类]() JS实现无限级分类 <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <meta name="viewport" content="width=device-width, initial-scale=1.0"> <title>Document</title> </head> <body> <script> let arr = [ { id: 1, 'auth_name': '商品管理', pid: 0 }, { id: 2, 'auth_name': '商品添加', pid: 1 }, { id: 3, 'auth_name': '商品列表', pid: 1 }, { id: 4, 'auth_name': '用户管理', pid: 0 }, { id: 5, 'auth_name': '用户添加', pid: 4 }, { id: 6, 'auth_name': '商品添加1', pid: 2 }, ] function buildTree(items) { // 创建一个空的映射,用于存放每个id对应的节点 const map = new Map(); // 遍历数组,建立id到节点的映射,并为每个节点初始化children数组 items.forEach(item => { map.set(item.id, { ...item, children: [] }); }); // 遍历数组,将每个节点添加到其父节点的children数组中 items.forEach(item => { // 如果当前节点不是根节点(pid不为0) if (item.pid !== 0) { // 从映射中获取父节点 const parent = map.get(item.pid); // 如果父节点存在,将当前节点添加到父节点的children数组中 if (parent) { parent.children.push(map.get(item.id)); } } }); // 过滤出根节点(pid为0)并返回 return Array.from(map.values()).filter(node => node.pid === 0); } const tree = buildTree(arr); console.log(tree); console.log(JSON.stringify(tree, null, 2)) </script> </body> </html>
-
![获取豆瓣电影所有分类下的所有电影下的每部电影的前100条好评]() 获取豆瓣电影所有分类下的所有电影下的每部电影的前100条好评 # 导入xpath模块 用于解析页面数据 from lxml import etree # 导入系统模块 用于自动创建目录 import os # 导入requests模块用于发送http请求 import requests import json # 发起请求获取数据 def get_content(url,data=[],ispost=0): # user-agent 设置头信息 模拟浏览器访问 headers = { "User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36", } if ispost: response = requests.post(url=url, headers=headers,data=data) else: response = requests.get(url=url, headers=headers) response.encoding = response.apparent_encoding return response.text # 根据电影Id获取电影的评论 def getCommentByMovieId(typeName,movieId,limit=100): try: url = f"https://movie.douban.com/subject/{movieId}/comments?percent_type=h&limit={limit}&status=P&sort=new_score" # 发送请求 获取页面源码 result = get_content(url) # 获取数据 etree1 = etree.HTML(result) # xpath解析 # 标题 title = etree1.xpath("//h1/text()")[0] # 评论人 authors = etree1.xpath("//span[@class='comment-info']/a/text()") # 评论时间 times = etree1.xpath("//span[@class='comment-info']/span[@class='comment-time ']/text()") # 评论内容 contents = etree1.xpath("//span[@class='short']/text()") moviePath = f"./movieCommentData/{typeName}" if not os.path.exists(moviePath): os.makedirs(moviePath) # 依次遍历,输出数据 s = "=" print(f"{s * 30}正在获取电影【{title}】{s * 30}") for i in range(len(authors)): print(f"评论人:'{authors[i]}'---评论内容:'{contents[i]}---评论时间:'{times[i].strip()}''") filename = moviePath + '/' + title + '.txt' with open(filename, 'a+', encoding="utf-8") as f: f.write(f"评论人:'{authors[i]}'---评论内容:'{contents[i]}'---评论时间:'{times[i].strip()}'\n") f.close() print(f"{s * 30}电影【{title}】获取完毕{s * 30}") except: pass url = "https://movie.douban.com/chart" # 发送请求 获取页面源码 result = get_content(url) # 获取数据 etree1 = etree.HTML(result) # xpath解析 typeUrl = etree1.xpath("//div[@class='types']/span/a/@href") typeUrlList = [] for url in typeUrl: typeName = url.split("&")[0].split('=')[1] print(f"正在获取【{typeName}】分类下的电影信息......") typeId = url.split("&")[1].split("=")[1] # 根据电影分类获取此分类下的电影总数 totalUrl = f"https://movie.douban.com/j/chart/top_list_count?type={typeId}&interval_id=100%3A90&action=" # 获取到此分类下的电影总数量 movieTotal = json.loads(get_content(totalUrl))['total'] print(f"{typeName}分类下的电影一共有{movieTotal}部") # 根据电影总数量依次获取这些电影 for i in range(movieTotal+1): baseUrl = f"https://movie.douban.com/j/chart/top_list?type={typeId}&interval_id=100%3A90&action=&start={i}&limit=1" movieInfo = json.loads(get_content(baseUrl))[0] # 获取电影Id movieId = movieInfo['id'] getCommentByMovieId(typeName,movieId)