
搜索到
82
篇与
的结果
-
![参加成考有感]() 参加成考有感 时隔多年,终于又一次以学生的身份坐在了教室里面,看着既熟悉又陌生的教室,既熟悉又陌生的老师,既熟悉又陌生的同学,真的是恍若隔世,思绪万千。距上次高考已经二十年了,再一次坐在考场里,为了自己的目标,自己的梦想,再次执笔答题,心情久久不能平静。其实作为专科生的我,每每被别人问到学历总是深感耻辱,所以每次都是巧妙的转移话题或者搪塞过去,实在绕不过去了,只能说自己学校不好,不出名,不提也罢。基本上到了这个时候就没有人再追着你不放了,可有的时候也会遇到打破砂锅问到底的,那就没有办法了,只能实话实说了。不知道诸位专科生是否和我有同样的感受,始终感觉专科的学历低人一等,不配提起,总觉得只有本科才配说出口。所以,专科的学历始终就像一根刺一样,深入肺腑,深入骨髓,拔不出来。平时不提倒也无妨,但凡聊起学历,一种自卑感瞬间贯穿全身。我跟身边的本科生聊过这个话题,他们会说,本科又怎样,该找不到工作还是一样找不到工作,所以即使拿个本科学历那又怎样?可是,话虽如此,我只会觉得你是站着说话不腰疼,说的轻松,你自己是本科,你当然觉得本科不过如此,没啥用了。后来,直到我身边的高中生和我聊天学历的话题的时候,我支支吾吾说出的专科,竟然也会成为他们羡慕的对象,那一刻我忽然明白,得不到的永远是最好的,我羡慕人家本科生,而他们羡慕我这个专科生。人都会羡慕自己极度欠缺,而别人拥有的东西。其实,早就有机会去选择专升本报名,提升学历了,只是一直以来工作稳定,学历对我来说也没啥用。因为,不跳槽,不找工作,学历就真的没用了。也不考公,也不考编,也不在体制内,也不晋升,也不靠学历涨工资,所以,学历对我来说,就真的是一张纸,那我又何必费时费力去学习,去考试呢。所以,这么多年,每次看到学历提升的事情,自己首先就否定了自己,不再考虑这个事了。真正出现转机的是今年过年的时候,我的一个表哥向我咨询了关于学历提升的事情,因为在政府机关上班,所以,学历对他来说就显得尤为重要。正好我们公司今年又是负责学历提升的一个报名点,我们也有同事是专门负责这个报名的,也给我们做了几期的培训,公司也号召全员参与到学历提升宣传报名这个工作中,然后借此机会我就去了解了一下关于学历提升,专升本报名的事情。这一了解不重要,弄得我自己心痒痒的,也想提升下自己的学历考个本科,趁自己还年轻,万一有机会用上呢?之前就是一直纠结到底有没有用的问题,直到现在不再纠结,趁自己还年轻,既然想了,就去干,毕竟大家不是常说,干就完了。自从不再纠结本科学历到底有没有用之后,我就开始思考如何报名的问题了。一方面,当年上学的时候没有好好学习,没有考上好的大学,在我的内心深处始终觉得低人一等,满是自卑,现在终于有个机会来证明自己,就很想通过自己的努力学习,再一次好好学习,我也不想证明自己多么了不起,就想通过自己的努力,再一次感受学习的状态,证明我还年轻,我还不算笨,之所以我当年没有考上好的大学不怪我脑子笨,只能怪我当时不努力,如果我这次顺利考上本科,就说明我还可以嘛,哈哈。另一方面,毕业这么多年,隔三差五总会梦回大学,梦回宿舍,那些常年不联系的大学同学,总会出现在我的梦里,一梦到回学校都是在宿舍里醒来,看着熟悉的同学、熟悉的宿舍,还和同学们一起欢声笑语,甚至我还告诉我的同学,我之前老做梦梦到你们,结果这次咱们真的相遇了,真是太好了,我还兴高采烈的和他们讲我之前做过的梦,结果早上醒来,竟然还是梦,梦中梦太痛苦了,太难受了,太折磨了。后来我查了很多资料才知道,原来,生活、工作压力过大,人都会自我逃避,大学那几年是最轻松,最安逸的几年,所以,梦里才会找一个地方逃避,说白了,纯粹是逃避现实。我感觉我被诅咒了,毕业十几年了,还隔三岔五梦到自己回到宿舍,只要醒来一定在宿舍床上,折磨我痛不欲生,这次也想通过考上本科破除诅咒。最后,还经常做奇怪的梦,梦见自己已经有了专科毕业证的情况下,竟然还坐在高三的教室里,准备着参加高考,心里还在想,要是考上,我再去上四年也是本科生了,即使考不上,反正我也已经大专毕业了,我也有专科毕业证托底,醒来之后才知道有多么的荒唐,你都大专毕业了,怎么还能坐在教室参加高考呢?但是,成人高考无疑是最好的选择,可以圆梦,我甚至在想我做这样的梦是不是就是在暗示我去努力学习,参加高考。以上三个原因促使我报名,学习,参加考试。既然下定了决心开始报名,也就不再纠结毕业证有没有用的问题了,先考了再说。接下来面临的就是报哪个学校,哪个专业的问题了。招生老师推荐的是一些民办本科院校,一些比较好考的,容易通过的学校。但,我不同意,既然下定决心参加成考了,还不给自己施加点压力吗?通过了解咨询,大家都说,不就是拿个毕业证吗?本科学校都没啥区别,不,我不,我不甘心,要报我就要报个难度大的,学校知名度高的,即使不好考,我也要努力去考,努力去学。我的心目大学也就两个郑州大学,河南大学,其他一概不考虑。当得知郑大没有合作的机构,是自主招生,考试比较难,后续流程也比较繁琐,就不再考虑了。正好招生老师说她就是河大的老师,那好,就直接毫不犹豫报了河大。据说,分数线会比省控线高一些,但是不管了,哪顾得了那么多了,先报了再说,我感觉我的底子不差,也能学的进去,也有时间去学,相信通过自己的努力,考上一个好学校,应该也不难,不管是为了面子还是为了毕业证的含金量,毅然选择了报名河大,虽然很多人劝我都差不多,但是河大更难,后期学习,考试,拿学位证流程更繁琐,但是我不服输,相信自己可以的。接下来的问题自然就是学习的问题了,首先看数学,结果高数一,硬着头皮看了两节课,什么极限啊,导数啊,愣是听不懂,也学不会,历年真题试卷是一道题也不会做,无奈,只有放弃。然后就开始看政治,学政治,硬着头皮又学了几天的政治,好像也听懂马哲,马原了,但是还是有点晕,几天之后发现学政治好痛苦,没办法,还是放弃了。最后就只剩下英语了,英语我是有点底子的,也有点基础的,毕竟当年上学时候学的还可以,还是能认识些单词的,目前的编程工作,也是跟单词打交道的,所以,很多单词还是认识的,可是一听课,彻底完蛋,毕竟当年的语法就没有学会,现在学着还是懵懵的,此时我的学习陷入了绝境。咨询了老学员的建议,第一,把政治作为得分的主力,不想看视频不想理解,那就刷题,刷各种模拟题,历年真题,测试题,一直刷一直刷,刷到考试为止。毕竟政治 35 道选择题,每道 2 分,选择题总分 70 分,如果刷的好,考个 5,60 分问题不大,至于后面的问答题,论述题,到时候随便写写,能得几分是几分吧。起初,我还背大题,可是效率极低,脑子也不好使了,背来背去还记不住。然后就刷了一段时间,最后 35 道题,差不多能对个 27,8 道,能考个 5,60 分。后面大题随便写写,政治考个 6,70 分我就知足了。接下来继续其他两门,还是硬着头皮看数学吧,不然一道题也不会,全靠蒙也不行啊!然后无意中在 B 站上看到了包子老师,在这里真的很感谢包子老师,讲课真的易懂,好学,幸亏遇到了包子老师,让我听懂了高数,愿意学下去,然后就用了半个多月的时间天天看他的视频,从第一章的极限 第二章的微分 第三章的积分 第四章的空间几何 第五章的多元函数 ,第六章的无穷级数 第七章的常微分方程,其实 我也就看了一半的课,后面很多很难,听不懂也懒得看了,心想数学能拿个 60 分就该知足了,所以看了前两章和第四章,第二章的一半,和第五章的一半,总共才看了一半的东西,不过我看了一遍之后开始刷政治视频,十一在家用了一周时间刷政治阿来老师的历年真题讲解,各种试题讲解。高数一大概学了有 20 多天,同样的视频,我学了整整三遍,做题的草稿纸用了 30 多张 A4 纸,黑色签字笔用了 3 支,中间穿插着十一,学一周的政治,学了 3 天的英语,背了英语的小作文,虽然也没怎么用上,做了十几套阅读理解,做了几套补全对话。终于,考试的时间还是到了。成考如期而至,十月 17 日大雨,驱车赶往 12km 外的考场。我坐在成考的考场里,写完题目静静发呆,我望向窗外被风吹的所剩无几的叶子,思绪一下子拉回多年前的教室。十几岁参加考试,是必须完成的任务,身边所有人推着你往前走,不用思考生活的压力,只管埋头向着目标奔跑。成年之后再来参加考试,完全是自己主动给自己争取的一次机会。白天要谋生,应付工作里的琐碎,处理生活里大大小小的难题,只有夜深人静的时候,才能硬挤出一点时间翻书复习。其中的疲惫和辛苦,只有自己心里清楚。很多人会质疑成考的价值,说这张文凭起不到多大作用,可当你走进考场,看见偌大的教室坐满了来自各行各业的人,就能明白大家奔赴这里的心意。18 岁走进考场,赌的是前程,满心都是滚烫的理想;成年之后走出考场,求的是底气,想要在现实生活里多一个选择。我们不再幻想一场考试就能彻底改写命运,只是不甘心困在原地。一纸文凭或许不是人生的解药,没办法瞬间解决所有难题,但它是普通人对抗平庸生活,一次温柔的自救。这场考试,是弥补年少留下的遗憾。学习从来不分年龄,任何时候愿意拿起书本,都是在慢慢成全自己。都说成考没用,考场却坐满了人。18 岁出考场怀揣理想,成年赴考是为生活,算是弥补年少的遗憾。经历了一次成考,感觉人生经历了一次蜕变。也算是经历了考前的学习,考前的挑灯夜战,做出题后的开心,做不出时候的郁闷,经历了考前的紧张不安,整夜睡不好,满脑子都梦到自己坐在考场里考试,经历了考试中的痛苦与煎熬,也经历了考后的失落,解放,以及与自己和解。今天看抖音的时候,好多人说,考试后又开始上班了,突然感觉这些参加成考的都很厉害,很伟大,大家都是忙里偷闲去学习,去提高自己,都很不容易,张开双臂,抱抱你们,抱抱自己。不要再说本科毕业证有没有用了,考试体验的是经历的过程,经历过就好,这段经历就难能可贵的,对我来说是刻骨铭心的。经历过就已经足够。要真说考证的目的,无外乎以下几个。有人为了编制,有人为了考公,有人为了涨工资,有人为了找工作,而我只为了弥补当年的遗憾,完成我的大学本科梦!加油!祝所有的考生都能顺利上岸!敬自己!
-
![那些年我们使用过的QQ签名]() 那些年我们使用过的QQ签名 你不懂我的沉默,又怎么会懂我的难过 ﹌有首歌叫你是我的眼,我怎么感觉我的眼瞎了很多次了 ﹌能够说出的委屈,便不算委屈。能够抢走的爱人,便不算爱人。当大部分人都在关注你飞的高不高时,只有少部分人关心你飞的累不累,这就是友情//试着用左手握住右手给自己最简单的温暖看到这条签名的孩子.祝你比我过的开心有时候、我们把签名改的那么频、只是想让别人知道你的心情、可是我们却忘了,也许别人根本没有注意。痛恨那种诅咒别人家人,让人转日志或者视频的人。 有木有一对情侣 没说分手 却很长时间都没有联系。“现在的女人真奇怪哦,上面穿羽绒服下面却穿丝袜。”“这你就不懂了吧,鲜奶要保温、火腿要冷藏。”有多少人像我一样、不敢跟他说话 、却一遍一遍打开他的资料又关上。 这年头,哭多了人家说你装可怜,笑多了人家说你装可爱,不哭不笑人家说你装成熟。为什么我们在扣扣上聊得那么多,面对面时却不知道说什么。害怕每次长时间的“正在输入”换来的都是一句:哦呵呵。多少人以友谊的名义,爱一个人。。。 女:你喜欢我哪一点,我改还不行吗? 男: 我就喜欢你不喜欢我这一点,你改啊,你改啊、、、每个成功男人的电脑桌面上,总有一个叫快播的图标.千万不要用自己的照片做QQ头像,不然当你下线了,就太不吉利了。歌,不是因为好听才听。而是因为歌词里面好像在诉说我们的故事。你知道吗?每当收到你说只有一个简单的“哦”,我想说的一大堆话却一句也说不出。人活着真有意思,活着活着就死了。总有那么一对情侣。还没牵手就分手。请珍惜我拿你当人的每一分钟上课的时候,有一个同学给我传了张纸条,看到内容 我很想扁他,写的是“在吗”有没有这么一个人 ,你会在听到他的 名 字 时 突 然 变 得 沉 默.女人总羡慕红太狼有那么爱她的灰太狼,却忘记了灰 太狼没抓到羊的这几年,红太狼对他的不离不弃大多数女人的第一次都给了一个不能和她结婚的男人别和我那么大声说话、 我小时候被狗吓着过妻子问丈夫“你希望是男孩还是女孩?”丈夫“如果是男孩,我们爷俩保护你;如果是女孩,我保护你们娘俩”有多少人,发表QQ签名只是为了让某人看见。不能在一起就不在一起吧,也许一辈子没那么长……
-
![centos系统 yum配置 初始化脚本]() centos系统 yum配置 初始化脚本 #删除系统原有的YUM源 rm -rf /etc/yum.repos.d/* #配置阿里云基础源(base,extras,updates) curl https://mirrors.aliyun.com/repo/Centos-7.repo -o /etc/yum.repos.d/CentOS-Base.repo #配置阿里云EPEL源 curl https://mirrors.aliyun.com/repo/epel-7.repo -o /etc/yum.repos.d/epel.repo #安装基本的软件包 yum install -y wget curl vim-enhanced git net-tools bash-completion #关闭防火墙 systemctl stop firewalld.service systemctl disable firewalld.service
-
![使用代理IP和访问控制策略提高爬虫效率]() 使用代理IP和访问控制策略提高爬虫效率 前言在进行网络爬虫工作时,经常会遇到被目标网站封禁的情况,尤其是频繁请求同一页面或同一接口时。为了解决这个问题,我们可以使用代理IP和访问控制来提高爬虫的稳定性和可靠性。本文将介绍如何使用代理IP和访问控制来优化爬虫的效率。一、爬虫代理IP的使用爬虫使用代理IP可以隐藏真实的访问源,模拟不同的用户请求,减少被封禁的可能性。以下是使用代理IP的一般步骤:1. 获取可用代理IP可以从代理IP提供商购买或使用免费的代理IP。免费的代理IP质量较低,容易被封禁,建议购买稳定可靠的代理IP。2. 验证代理IP的可用性通过发送请求到目标网站,验证代理IP是否可用。一般可以使用requests库发送HTTP请求,并根据返回的状态码来判断代理IP的有效性。import requests proxy = {'http': 'http://your_proxy_ip:your_proxy_port'} try: response = requests.get(url, proxies=proxy, timeout=5) if response.status_code == 200: print('代理IP可用') else: print('代理IP无效') except Exception as e: print('请求失败', e)3. 设置代理IP在爬虫程序中使用代理IP,使用requests库提供的proxies参数,将代理IP传入访问请求中,从而实现了使用代理IP请求网页的功能。import requests proxy = {'http': 'http://your_proxy_ip:your_proxy_port'} try: response = requests.get(url, proxies=proxy, timeout=5) if response.status_code == 200: print(response.text) else: print('请求失败') except Exception as e: print('请求失败', e)二、访问控制除了使用代理IP,访问控制也是一个重要的优化策略。通过设置访问频率和请求间隔,可以避免对目标网站造成过大的访问压力,进而减少被封禁的风险。以下是一些常用的访问控制方法:1. 设置请求头信息在发送请求时,设置User-Agent、Referer等请求头信息,模拟正常的用户请求。可以通过随机选择不同的User-Agent来增加请求的随机性。import requests headers = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3', 'Referer': 'http://www.example.com' } try: response = requests.get(url, headers=headers, timeout=5) if response.status_code == 200: print(response.text) else: print('请求失败') except Exception as e: print('请求失败', e)2. 设置访问频率和请求间隔在爬取过程中,设置合理的访问频率和请求间隔,避免过于频繁的请求。可以使用time模块的sleep方法来控制请求间隔时间。import requests import time headers = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3' } for i in range(10): try: response = requests.get(url, headers=headers, timeout=5) if response.status_code == 200: print(response.text) else: print('请求失败') except Exception as e: print('请求失败', e) time.sleep(5) # 每隔5秒发送一次请求三、综合应用在实际爬虫工作中,我们通常同时使用代理IP和访问控制来提高爬取的稳定性和可靠性。以下是一个综合应用的示例:import requests import random import time proxy_list = ['http://your_proxy_ip1:your_proxy_port1', 'http://your_proxy_ip2:your_proxy_port2'] # 代理IP列表 headers = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3', 'Referer': 'http://www.example.com' } for i in range(10): proxy = {'http': random.choice(proxy_list)} try: response = requests.get(url, headers=headers, proxies=proxy, timeout=5) if response.status_code == 200: print(response.text) else: print('请求失败') except Exception as e: print('请求失败', e) time.sleep(5) # 每隔5秒发送一次请求上述示例中,我们使用了随机选择代理IP的方式来模拟不同的访问源,同时设置了请求头信息和请求间隔。这样可以有效地提高爬虫的稳定性和可靠性。总结使用代理IP和访问控制是提高爬虫稳定性和可靠性的常用方法。通过使用不同的代理IP和设置合理的访问频率和请求间隔,我们可以减少被封禁的风险,提高爬虫的效率和成功率。在实际工作中,需要根据目标网站的具体情况来选择合适的代理IP和访问控制策略。在使用代理IP时,需要注意代理IP的质量和稳定性,避免使用低质量的代理IP,以免影响爬虫的效果。另外,使用代理IP和访问控制时也需要遵守相关法律法规和网站的使用规定,以免违规行为带来的法律风险和不良影响。
-
![电影天堂全部类型下的所有电影]() 电影天堂全部类型下的所有电影 # -*- coding:utf-8 -*- # @time:2025/7/9 9:50 # @author:张旭辉 # @file : 1-获取全国城市.py # @编辑器: PyCharm import time # 时间 import random # 随机数 import re # 正则表达式 一套规则 用于匹配符号条件的记录 from lxml import etree # 从lxml中导入etree 目的是为了解析网页源码 # 从myhttp.py文件中 导入模块 具体 函数是get_data from myhttp import get_data # 准备url 1 就是喜剧片的类型 第1页 2 3 for i in range(0,21): url = f"https://www.dytt8899.com/{i}/index.html" print(url) # 发送请求 response = get_data(url) # 获取数据 # 加载源码 html = etree.HTML(response.text) # xpath解析 # 获取当前类型电影的最大页码 类型转成int pagemax = int(html.xpath("//select/option[last()]/text()")[0].split(" ")[1]) for page in range(1,pagemax+1): # time.sleep(random.randint(1,10))# 睡觉 单位秒 随机范围1-10秒 if page == 1: url = f"https://www.dytt8899.com/{i}/index.html" else: url = f"https://www.dytt8899.com/{i}/index_{page}.html" # 再次发送请求 # 发送请求 response = get_data(url) # 获取数据 # 加载源码 html = etree.HTML(response.text) # 从第page页中取电影类型 type = ''.join(re.findall(r'[\u4e00-\u9fa5]+', html.xpath("//h1//font/text()")[0])) # 当前页的全部电影数据30条 tables = html.xpath("//div[@class='co_content8']/ul//table") print(f"============================正在下载【{type}】第{page}/{pagemax}页数据================================") with open(f"data/{type}.txt","a",encoding="utf-8") as f: f.write(f"\n---------------------------------{page}/{pagemax}-----------------------------------------\n") for table in tables: date = table.xpath(".//tr[3]/td[2]/font[1]/text()")[0] # 日期 score = table.xpath(".//tr[3]/td[2]/font[2]/text()")[0] # 评分 score = re.sub(r'\s+', ' ', score).strip() # 去了回车换行空格之后的评分 title_director = table.xpath(".//tr[4]/td[1]/p[1]/text()")[0] # 片名 导演 title_director = re.sub(r'\s+', ' ', title_director).strip() # 去了回车换行空格之后的 片名 导演 print(date,score,title_director) # 打印 f.write(f"{date} {score} {title_director}\n") # 写入文件 f.write(f"\n---------------------------------{page}-----------------------------------------\n") print(f"============================【{type}】第{page}/{pagemax}页数据下载完成================================") print(f"{type}下载完成")
-
![电影天堂某分类下的所有电影]() 电影天堂某分类下的所有电影 # -*- coding:utf-8 -*- # @time:2025/7/9 9:50 # @author:张旭辉 # @编辑器: PyCharm import time # 时间 import random # 随机数 import re # 正则表达式 一套规则 用于匹配符号条件的记录 from lxml import etree # 从lxml中导入etree 目的是为了解析网页源码 # 从myhttp.py文件中 导入模块 具体 函数是get_data from myhttp import get_data # 准备url 1 就是喜剧片的类型 第1页 url = "https://www.dytt8899.com/2/index.html" # 发送请求 response = get_data(url) # 获取数据 # 加载源码 html = etree.HTML(response.text) # xpath解析 # 获取当前类型电影的最大页码 类型转成int pagemax = int(html.xpath("//select/option[last()]/text()")[0].split(" ")[1]) for page in range(1,pagemax+1): time.sleep(random.randint(1,10))# 睡觉 单位秒 随机范围1-10秒 if page == 1: url = "https://www.dytt8899.com/1/index.html" else: url = f"https://www.dytt8899.com/1/index_{page}.html" print(f"============================正在下载第{page}页数据================================") # 再次发送请求 # 发送请求 response = get_data(url) # 获取数据 # 加载源码 html = etree.HTML(response.text) # 从第page页中取电影类型 type = ''.join(re.findall(r'[\u4e00-\u9fa5]+', html.xpath("//h1//font/text()")[0])) # 当前页的全部电影数据30条 tables = html.xpath("//div[@class='co_content8']/ul//table") with open(f"data/{type}.txt","a",encoding="utf-8") as f: f.write(f"\n---------------------------------{page}-----------------------------------------\n") for table in tables: date = table.xpath(".//tr[3]/td[2]/font[1]/text()")[0] # 日期 score = table.xpath(".//tr[3]/td[2]/font[2]/text()")[0] # 评分 score = re.sub(r'\s+', ' ', score).strip() # 去了回车换行空格之后的评分 title_director = table.xpath(".//tr[4]/td[1]/p[1]/text()")[0] # 片名 导演 title_director = re.sub(r'\s+', ' ', title_director).strip() # 去了回车换行空格之后的 片名 导演 print(date,score,title_director) # 打印 f.write(f"{date} {score} {title_director}\n") # 写入文件 f.write(f"\n---------------------------------{page}-----------------------------------------\n") print(f"============================第{page}页数据下载完成================================") print("下载完成")
-
![梨视频视频爬取]() 梨视频视频爬取 # -*- coding:utf-8 -*- # @time:2025/7/8 10:10 # @author:张旭辉 # @file : zhang.py # @编辑器: PyCharm import requests def get_data(url): headers = { "user-agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/138.0.0.0 Safari/537.36", } response = requests.get(url=url,headers=headers) response.encoding = response.apparent_encoding return response def get_video_url(url,contId,params): headers = { "user-agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/138.0.0.0 Safari/537.36", "cookie":'PEAR_UUID=d6f6a867-a448-4561-9861-0170363cfa46; _uab_collina=175188032684858668947395; p_h5_u=EDC6CA6A-43EB-4E01-B161-70C22435000A; Hm_lvt_9707bc8d5f6bba210e7218b8496f076a=1751880327,1752203335; HMACCOUNT=15F47A8122133E49; Hm_lpvt_9707bc8d5f6bba210e7218b8496f076a=1752203336; tgw_l7_route=e0ec575606f95cc9ad003a83f9f8574f; JSESSIONID=7E3F76514FB7332116890EA82275AA69', "referer":f"https://www.pearvideo.com/video_{contId}" } # verify = False 发送get请求的时候 不去校验证书 response = requests.get(url=url,headers=headers,params=params) response.encoding = response.apparent_encoding return response # 准备当前页面url地址 url = "https://www.pearvideo.com/video_1801228" # 从url中获取当前视频的id contId = url.split("_")[-1] # 向指定服务器发送请求 video_url = "https://www.pearvideo.com/videoStatus.jsp" response = get_video_url(video_url,contId,params={"contId":contId}) # 获取视频假地址 srcUrl = response.json()['videoInfo']['videos']['srcUrl'] # 假地址: https://video.pearvideo.com/mp4/short/20250709/1752204172726-16056591-hd.mp4 print(srcUrl) # 真实地址:https://video.pearvideo.com/mp4/short/20250709/cont-1801228-16056591-hd.mp4 # 需要把 1752204172726 替换成 cont-1801228 # 1.根据srcUrl 提取对应的这串数字 fake = srcUrl.split('/')[-1].split('-')[0] print(fake) # 2.替换 real_video_url = srcUrl.replace(fake,f"cont-{contId}") print(real_video_url) # 向真实视频地址发送请求保存数据 response = get_data(real_video_url) # 下载到本地 print("正在下载") with open(f"{contId}.mp4","wb") as f: f.write(response.content) print("下载完成")
-
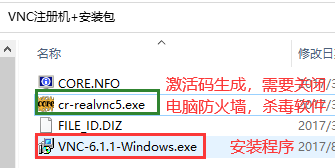
![VNC远程控制]()
-
![中国式英语]() 中国式英语 在中国,有这么一种神秘的语言,叫“Chinese English”。它言简意赅,生动有趣。简单中带着一丝繁复,调皮中又有着一缕文艺!我们中国人听了,常常眼神对视,就露出蜜汁微笑。“哦,我懂了,原来如此,竟然还TM可以这么说!”外国人却是一脸黑线。“what fuck!”这群中国人在搞什么鬼,我怎么听不懂?”1、you di da di da me,I hua la hua la you.滴水之恩,当涌泉相报2、Know is know, no know is no know, it s know.知之为知之,不知为不知!3、You roll as far as you can.有多远给我滚多远!4、If you want money, I have none; If you want life, I have one.老子要钱没有,要命一条!5、You are really a no three no four man.你真是一个不三不四的人!6、How are you ? 怎么是你?How old are you? 怎么老是你?7、We two who and who!老铁,咱两谁跟谁啊!8、You have seed. I will give you some color to see see. Brothers! Together up! 你有种,我给你点颜色看看,兄弟们,一起上。9、Horse horse tiger tiger. 马马虎虎10、you don’t bird me,I don’t bird you 你不鸟我,我也不鸟你。11、You Give Me Stop! 你给我站住!12、watch sister 表妹13、American Chinese not enough 美中不足14、Where cool where you stay!哪凉快上哪呆着15、heart flower angry open 心花怒放16、colour wolf 色狼17、People mountain and people sea. 人山人海18、Moring three night four.朝三暮四。19、no three no four 不三不四20、you have two down son。 你有两下子。21、let the horse come on 放马过来22、I give you face you don’t wanna face 给你脸你不要脸23、red face know me 红颜知己24、seven up eight down 七上八下25、you try try see!你试试看!26、love who who 爱谁谁27、go you mother's 去你妈28、May I borrow your light? 借光29、dragon born dragon,chicken born chicken,mouse’son can make hole!龙生龙,凤生凤,老鼠的儿子会打洞30、king eight eggs 王八蛋31、no care three seven twenty one 不管三七二十一32、go and look 走着瞧33、no money no talk 没钱免谈34、you me you me 彼此彼此35、you can kill me ,but you can`t fuck me -士可杀不可辱36、Long time no see。好久不见。37、People mountain people sea 人山人海38、No zuo no die 。不作就不会死。39、You can you up。你行你上。40、No can no BB (不行就别说话)
-
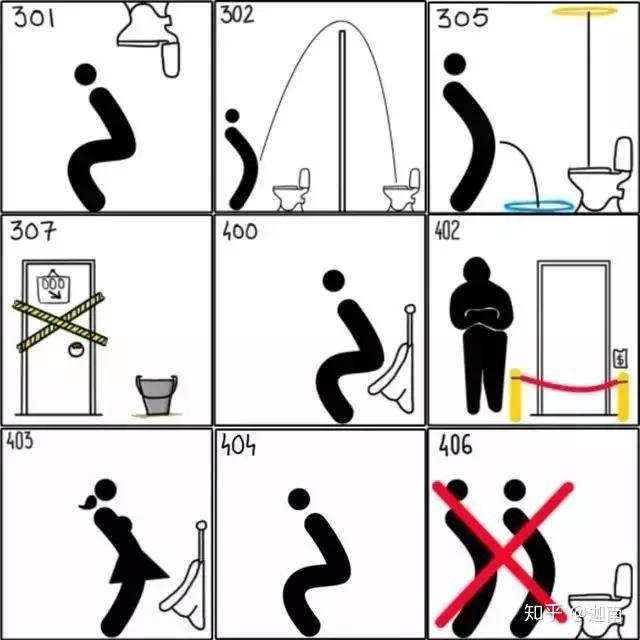
![HTTP状态码详解]() HTTP状态码详解 当浏览者访问一个网页时,浏览者的浏览器会向网页所在服务器发出请求。当浏览器接收并显示网页前,此网页所在的服务器会返回一个包含HTTP状态码的信息头(server header)用以响应浏览器的请求。HTTP状态码的英文为HTTP Status Code。下面是常见的HTTP状态码:200 - 请求成功301 - 资源(网页等)被永久转移到其它URL404 - 请求的资源(网页等)不存在500 - 内部服务器错误HTTP 状态代码表示什么意思?HTTP 状态码(英语:HTTP Status Code)是用以表示 HTTP 响应状态的 3 位数字代码。比如:1xx:消息2xx:成功3xx:重定向4xx:客户端错误5xx:服务器错误熟记这些状态码可以让我们在快速定位 Web 开发中遇到的问题、编写符合规范的接口服务,那么下面就让我们看看这些死板的 3 位数字都是什么意思。HTTP状态码分类HTTP状态码由三个十进制数字组成,第一个十进制数字定义了状态码的类型,后两个数字没有分类的作用。HTTP状态码共分为5种类型:1开头(信息响应)1xx(临时响应):信息性状态码,表示服务器已接收了客户端请求,客户端可继续发送请求。1xx(临时响应)表示临时响应并需要请求者继续执行操作的状态代码。代码 说明(继续) 请求者应当继续提出请求。 服务器返回此代码表示已收到请求的第一部分,正在等待其余部分。(切换协议) 请求者已要求服务器切换协议,服务器已确认并准备切换。2开头(成功响应)2xx (成功)表示成功处理了请求的状态代码。代码 说明(成功) 服务器已成功处理了请求。 通常,这表示服务器提供了请求的网页。(已创建) 请求成功并且服务器创建了新的资源。(已接受) 服务器已接受请求,但尚未处理。(非授权信息) 服务器已成功处理了请求,但返回的信息可能来自另一来源。(无内容) 服务器成功处理了请求,但没有返回任何内容。(重置内容) 服务器成功处理了请求,但没有返回任何内容。(部分内容) 服务器成功处理了部分 GET 请求。3开头(重定向)3xx (重定向) 表示要完成请求,需要进一步操作。 通常,这些状态代码用来重定向。(多种选择) 针对请求,服务器可执行多种操作。 服务器可根据请求者 (user agent) 选择一项操作,或提供操作列表供请求者选择。(永久移动) 请求的网页已永久移动到新位置。 服务器返回此响应(对 GET 或 HEAD 请求的响应)时,会自动将请求者转到新位置。(临时移动) 服务器目前从不同位置的网页响应请求,但请求者应继续使用原有位置来进行以后的请求。(查看其他位置) 请求者应当对不同的位置使用单独的 GET 请求来检索响应时,服务器返回此代码。(未修改) 自从上次请求后,请求的网页未修改过。 服务器返回此响应时,不会返回网页内容。(使用代理) 请求者只能使用代理访问请求的网页。 如果服务器返回此响应,还表示请求者应使用代理。(临时重定向) 服务器目前从不同位置的网页响应请求,但请求者应继续使用原有位置来进行以后的请求。4开头(客户端响应)4xx(请求错误) 这些状态代码表示请求可能出错,妨碍了服务器的处理。代码 说明(错误请求) 服务器不理解请求的语法。(未授权) 请求要求身份验证。 对于需要登录的网页,服务器可能返回此响应。(禁止) 服务器拒绝请求。(未找到) 服务器找不到请求的网页。(方法禁用) 禁用请求中指定的方法。(不接受) 无法使用请求的内容特性响应请求的网页。(需要代理授权) 此状态代码与 401(未授权)类似,但指定请求者应当授权使用代理。(请求超时) 服务器等候请求时发生超时。(冲突) 服务器在完成请求时发生冲突。 服务器必须在响应中包含有关冲突的信息。(已删除) 如果请求的资源已永久删除,服务器就会返回此响应。(需要有效长度) 服务器不接受不含有效内容长度标头字段的请求。(未满足前提条件) 服务器未满足请求者在请求中设置的其中一个前提条件。(请求实体过大) 服务器无法处理请求,因为请求实体过大,超出服务器的处理能力。(请求的 URI 过长) 请求的 URI(通常为网址)过长,服务器无法处理。(不支持的媒体类型) 请求的格式不受请求页面的支持。(请求范围不符合要求) 如果页面无法提供请求的范围,则服务器会返回此状态代码。(未满足期望值) 服务器未满足"期望"请求标头字段的要求。5开头(服务端响应)5xx(服务器错误)这些状态代码表示服务器在尝试处理请求时发生内部错误。 这些错误可能是服务器本身的错误,而不是请求出错。代码 说明(服务器内部错误) 服务器遇到错误,无法完成请求。(尚未实施) 服务器不具备完成请求的功能。 例如,服务器无法识别请求方法时可能会返回此代码。(错误网关) 服务器作为网关或代理,从上游服务器收到无效响应。(服务不可用) 服务器目前无法使用(由于超载或停机维护)。 通常,这只是暂时状态。(网关超时) 服务器作为网关或代理,但是没有及时从上游服务器收到请求。(HTTP 版本不受支持) 服务器不支持请求中所用的 HTTP 协议版本。趣味图解HTTP状态码的含义HTTP状态码(HTTP Status Code)是用以表示网页服务器HTTP响应状态的3位数字代码。我们可以通过查看HTTP状态码来判断服务器状态,常见的有404 、502等;但是其他不是很常见的状态码都代表什么状态呢?下面有两张有趣的图片,让你瞬间都能理解了。HTTP状态码(图一)301—永久移动。被请求的资源已被永久移动位置;302—请求的资源现在临时从不同的 URI 响应请求;305—使用代理。被请求的资源必须通过指定的代理才能被访问;307—临时跳转。被请求的资源在临时从不同的URL响应请求;400—错误请求;402—需要付款。该状态码是为了将来可能的需求而预留的,用于一些数字货币或者是微支付;403—禁止访问。服务器已经理解请求,但是拒绝执行它;404—找不到对象。请求失败,资源不存在;406—不可接受的。请求的资源的内容特性无法满足请求头中的条件,因而无法生成响应实体;HTTP状态码(图二)408—请求超时;409—冲突。由于和被请求的资源的当前状态之间存在冲突,请求无法完成;410—遗失的。被请求的资源在服务器上已经不再可用,而且没有任何已知的转发地址;413—响应实体太大。服务器拒绝处理当前请求,请求超过服务器所能处理和允许的最大值。417—期望失败。在请求头 Expect 中指定的预期内容无法被服务器满足;418—我是一个茶壶。超文本咖啡罐控制协议,但是并没有被实际的HTTP服务器实现;420—方法失效。422—不可处理的实体。请求格式正确,但是由于含有语义错误,无法响应;500—服务器内部错误。服务器遇到了一个未曾预料的状况,导致了它无法完成对请求的处理;最无耻的 HTTP 常用状态码图解之前有朋友发过一篇 HTTP 状态码大全,我补充一篇,也是网上偶然看见的图,觉得虽然很没有节操但是却很形象生动,分享出来共 High301 永久移动位置,被请求的资源已经被永久性的转移了位置 302 您请求的资源现在需要临时通过其他的 URI 来获取 305 使用代理,被请求的资源必须通过指定的代理才能访问到 307 临时跳转。被请求的资源在临时从不同的URL响应请求 400 请求错误 402 该状态码是为了将来可能的需求而预留的,比如可能用于一些数字货币或者是微支付 403 禁止访问。服务器已经理解请求,但是拒绝执行它 404 找不到对象。请求失败,资源不存在,程序员找对象简直是宇宙谜题 406 不可接受的。请求的资源的内容特性无法满足请求头中的条件,因而无法生成响应实体408 请求超时,请活活憋死吧 409 请求冲突。由于和被请求的资源的当前状态之间存在冲突,请求无法完成 410 遗失的。被请求的资源在服务器上已经不再可用,而且没有任何已知的转发地址 413 响应实体太大。服务器拒绝处理当前请求,请求超过服务器所能处理和允许的最大值 417 期望失败。在请求头 Expect 中指定的预期内容无法被服务器满足 418 我是一个茶壶。超文本咖啡罐控制协议,但是并没有被实际的HTTP服务器实现 420 方法失效 422 不可处理的实体。请求格式正确,但是由于含有语义错误,无法响应 500 服务器内部错误。服务器遇到了一个未曾预料的状况,导致了它无法完成对请求的处理一文牢记HTTP状态码(图解HTTP状态码)HTTP状态码是干什么的?HTTP状态码负责表示客户端HTTP请求的返回结果、标记服务器的处理是否正常、通知出现的错误等工作。状态码告知从服务器端返回的请求结果状态码的职责是当客户端向服务端发送请求时,描述返回的请求结果。借助状态吗,用户可以知道服务器端是正常处理了请求,还是出现了错误。2XX 成功状态码详述2XX的响应结果表明请求被正常处理了200 OK表示从客户端发来的请求在服务端被正常处理了。在响应报文内,随状态码一起返回的信息会因方法的不同而发生改变。比如,使用GET方法时,对应请求资源的实体会做为响应返回;而使用HEAD方法时,对应请求资源的实体首部不随报文主体作为响应返回(即在响应中只返回首部,不会返回时主体部分)。204 NoContent该状态码代表服务器接收的请求已成功处理,但在返回的响应报文中不含实体的主体部分。另外,也不允许返回任何实体的主体。比如,当从浏览器发出请求处理后,返回204响应,那么浏览器显示的页面不发生更新。一般在只需要从客户端往服务器发送信息,而对客户端不需要发送新信息内容的情况下使用。206 Partial Content该状态码表示服务端进行了范围请求,而服务器成功执行了这部分的GET请求。响应报文中包含Content-Range制定范围的实体内容。3XX 重定向3XX响应结果表明浏览器需要执行某些特殊的处理以正确处理请求。301 Moved Permanently永久重定向。该状态码表示请求的资源已被分配了新的URI,以后应使用资源现在所指的URI。也就是说,如果已经把资源对应的URI保存为书签了,这是应该按Location首部字段提示的URI重新保存。302 Found临时重定向。该状态码表示请求的资源已被分配了新的URI,希望用户(本次)能使用新的URI访问。和301状态码相似,但302状态码代表的资源不是被永久移动,只是临时性质的。换句话说,已移动的资源对应的URI将来还有可能会发生改变。303 See Other该状态码表示由于请求对应的资源存在着另一个URI,应使用GET方法定向获取请求的资源。303状态码和302状态码有着相同的功能,但303状态码明确表示客户端应采用GET方法获取资源,这点与302状态码有区别。301,302,303之间的联系当301、302、303响应状态码返回时,几乎所有的浏览器都会把POST改成GET,并删除请求报文内的主体,之后请求会自动再次发送。301,302标准是禁止将POST方法改变成FET方法,但实际使用时大家都会这么做。304 Not Modified该状态码表示客户端发送附带条件的请求时,服务器允许请求访问资源,但未满足条件的情况。304状态码返回时,不包含任何响应的主体部分。304虽然被划分在3XX类别中,但是和重定向没有关系。307 Temporary Redirect临时重定向。该状态码与302有着相同的含义。尽管302标准禁止POST变换成GET,但实际使用时大家并不遵守。307会遵照浏览器标准,不会从POST变成GET。但是,对于处理响应时的行为,每种浏览器有可能出现不同的情况。4XX 客户端错误4XX的响应结果表明客户端时发生错误的原因所在。400 Bad Request该状态码表示请求报文中存在语法错误。当错误发生时,需修改请求的内容后再次发送请求。另外,浏览器会像200 OK一样对待该状态码。401 Unauthorized该状态码表示发送请求需要有通过HTTP认证(BASIC认证、DIGEST认证)的认证信息。另外若之前已进行过1次请求,则表示用户认证失败。返回含有401的响应必须包含一个适用于被请求资源的WWW-Authenticate首部用于质询(challenge)用户信息。当浏览器初次接收到401响应,会弹出认证用的对话窗口。403 Forbidden该状态码表明对请求资源的访问被服务器拒绝了。服务器没有必要给出拒绝的详细理由,但如果想做说明的话,可以在实体的主体部分对原因进行描述,这样就能让用户看到。未获得文件系统的访问授权,访问权限出现某些问题(从未授权的发送源IP地址试图访问)等列举的情况都有可能是发生403的原因。404 Not Found该状态码表示服务器上无法找到请求的资源。除此之外,也可以在服务器端拒绝请求且不想说明理由时使用。5XX 服务器错误5XX的响应结果表明服务器本身发生错误。500 Internal Server Error该状态码表明服务器端在执行请求时发生了错误。也有可能是Web应用存在的bug或某些临时的故障。503 Service Unavailable